Entropy-SGD:让梯度下降偏向宽阔的损失谷
训练神经网络(neural network, NN)时,我们通常关注优化过程中的每一步:更新方向是什么、步长多大,以及训练损失是否下降。较少被直接讨论的问题是:优化结束后,参数 $\theta_T$ 位于什么样的损失地形中?把损失地形(loss landscape)想象成山谷,最后落脚的位置是宽阔平坦的盆地,还是陡峭狭窄的深谷?
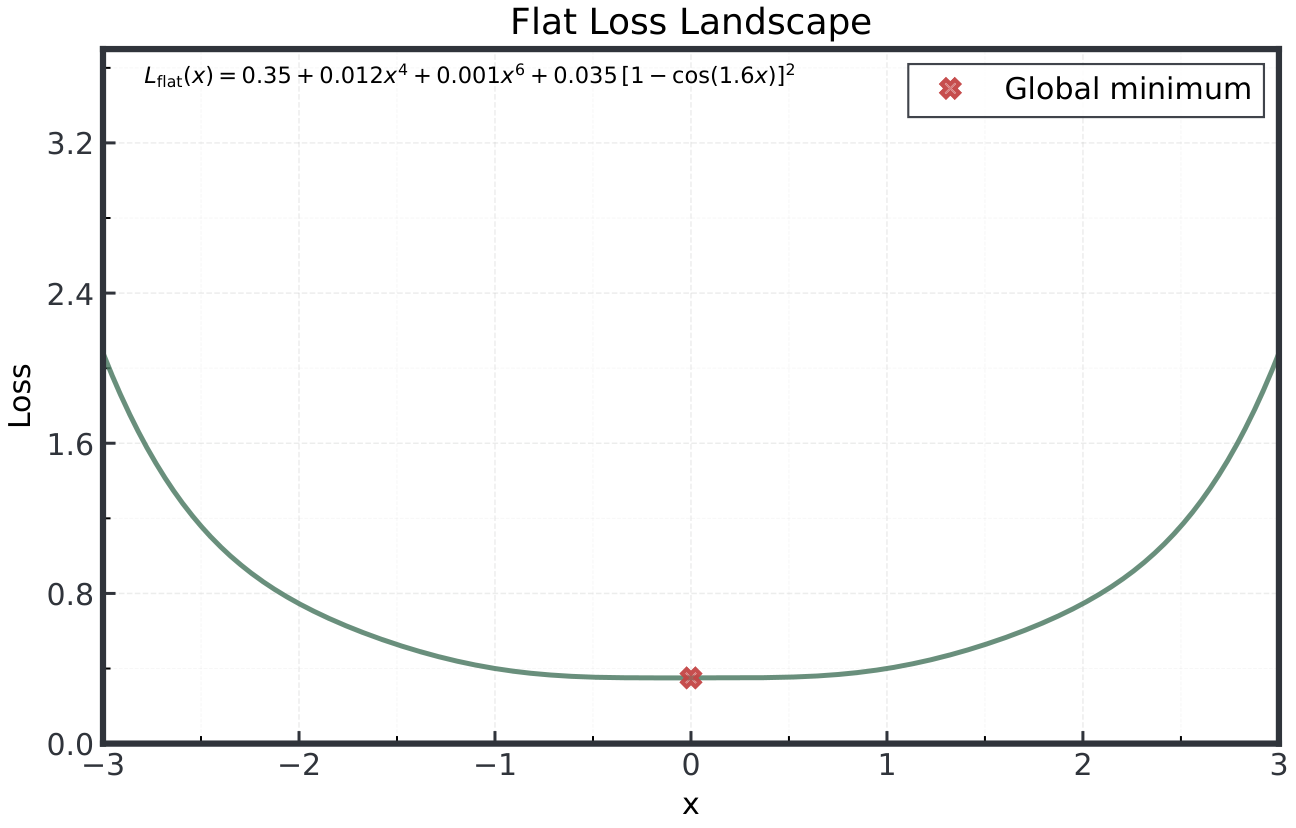
(a) 一维平坦损失景观。
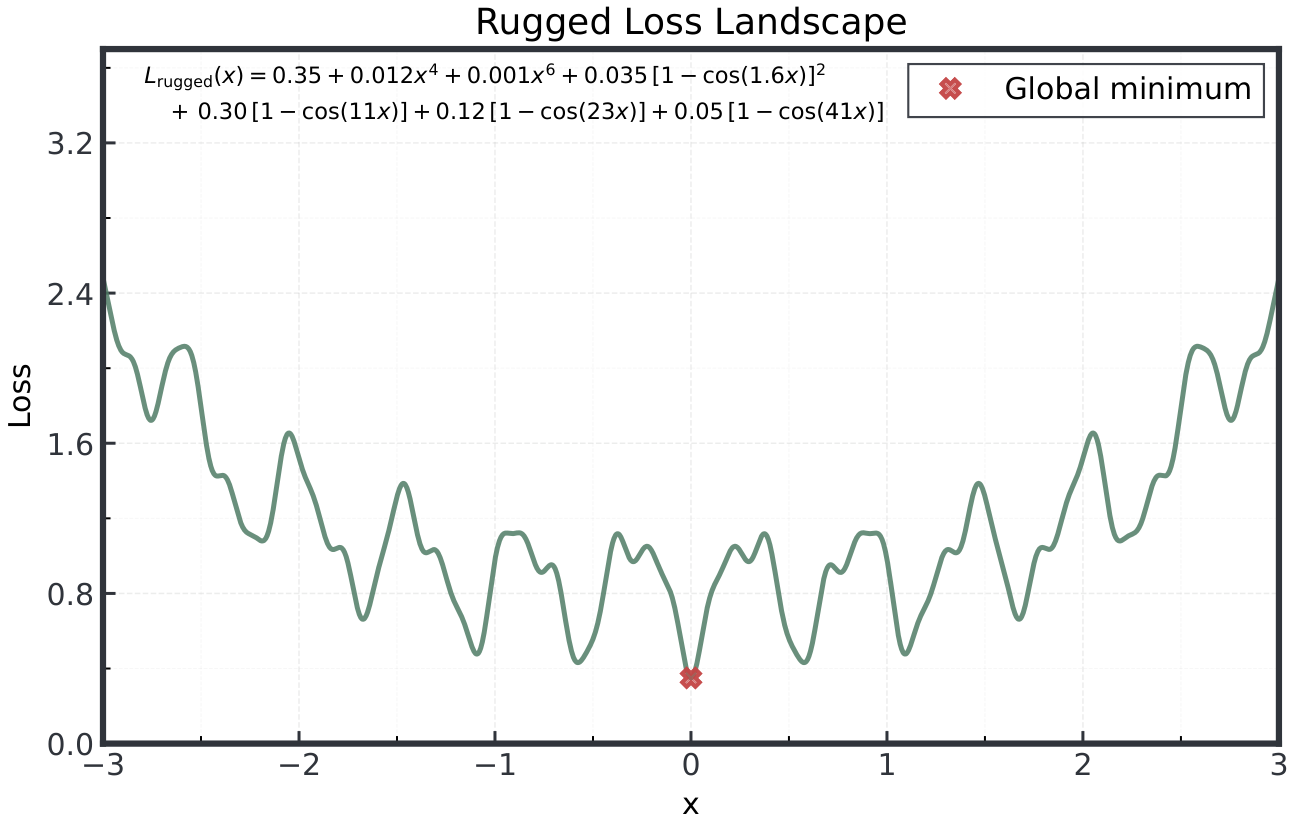
(b) 一维尖锐损失景观。
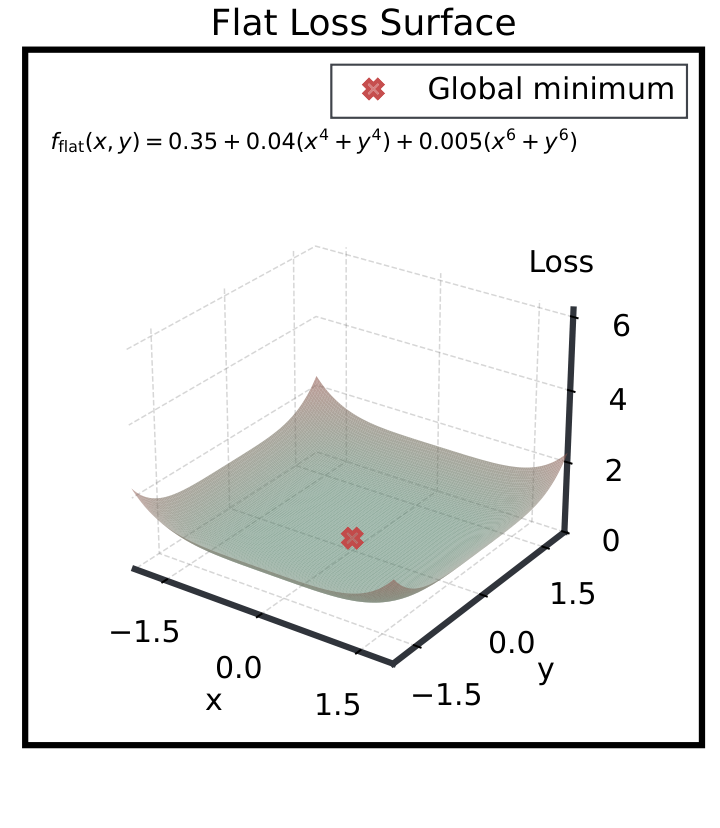
(c) 二维平坦损失景观。
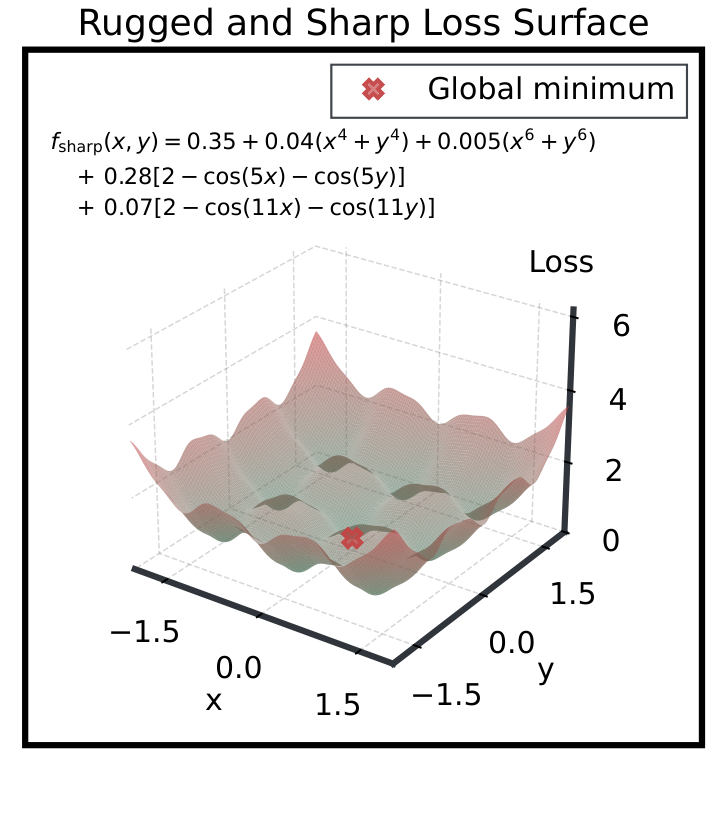
(d) 二维尖锐损失景观。
泛化较好的解可能位于宽阔区域
一些研究通过实验观察到,泛化较好的模型参数往往位于损失地形中较宽的山谷(wide valley)内。例如,Entropy-SGD 的研究检查了使用 Adam 在 MNIST 上训练的 CNN 的 Hessian 特征值分布 Chaudhari et al., 2017:
- 约 94% 的方向上的特征值绝对值小于 $10^{-4}$,也就是这些方向的曲率很小。
- 正特征值呈长尾分布,最大值接近 40;负特征值的分布较短,最小值约为 $-0.46$。
这一结果说明,某些训练结束后同时具有较低训练损失和验证损失的参数,其周围有许多曲率很小的方向。这样的解可以被形容为位于宽阔区域,而不是狭窄、孤立的低点。由此,一个自然的研究动机是:如果优化过程能找到位于宽阔区域的参数,是否可能获得更好的泛化表现?之后针对泛化度量的系统比较也讨论了损失地形几何与泛化之间的关系 Jiang et al., 2020。
即使常规优化器有时会收敛到这类区域,这也属于优化过程带来的隐式偏好。如果我们希望解显式地偏向宽阔区域,就需要先把“宽阔”写成可以计算的优化目标。
一种直接思路是使用 Hessian 的特征值或曲率来衡量局部地形,但计算完整 Hessian 及其谱通常成本很高。Entropy-SGD 因此转向统计物理中的局部熵(local entropy),把一定范围内的低损失解的整体贡献纳入目标中。局部熵的思想也用于约束满足问题中的解空间采样 Baldassi et al., 2016。
用局部熵描述宽阔区域
给定训练集 $\mathcal{S}=\lbrace(x_i,y_i)\rbrace_{i=1}^n$、模型参数 $\theta$ 和单样本损失 $\ell(x,y;\theta)$,通常的经验训练损失为
\[L_{\mathcal{S}}(\theta) = \frac{1}{n}\sum_{i=1}^{n}\ell(x_i,y_i;\theta).\]Entropy-SGD 定义了新的目标,即参数 $\theta$ 周围的局部熵:
\[F_{\mathcal{S}}(\theta,\gamma) = \log \int_{\theta'} \exp\left( -L_{\mathcal{S}}(\theta') -\frac{\gamma}{2}\lVert\theta-\theta'\rVert_2^2 \right)\,d\theta'.\]其中,$\theta’$ 是邻域内的候选参数,$\gamma$ 是控制邻域范围的参数(scope)。被积函数对两种情况赋予较大权重:候选参数的训练损失低,以及候选参数离 $\theta$ 较近。$\gamma$ 越小,距离惩罚越弱,较远的候选解也能对局部熵有明显贡献;$\gamma$ 越大,局部熵越集中在 $\theta$ 周围。
因此,最大化 $F_{\mathcal{S}}(\theta,\gamma)$ 会奖励那些邻域内聚集了许多低损失参数的解。若只有某个孤立点损失很低,对积分的贡献可能有限;如果低损失延伸到一片较宽的区域,则会累积出更大的局部熵。这就为“偏向宽阔的低损失区域”提供了一个目标函数。
相应地,Entropy-SGD 最小化局部熵的相反数:
\[\min_{\theta}\; -F_{\mathcal{S}}(\theta,\gamma) = -\log \int_{\theta'} \exp\left( -L_{\mathcal{S}}(\theta') -\frac{\gamma}{2}\lVert\theta-\theta'\rVert_2^2 \right)\,d\theta'.\]两层优化过程
Entropy-SGD 有内外两层循环:内层使用随机梯度朗之万动力学(stochastic gradient Langevin dynamics, SGLD)在 $\theta$ 附近采样并估计局部熵的梯度;外层再沿估计出的梯度更新 $\theta$,完成类似随机梯度下降(SGD)的优化步骤。由于局部熵本身包含对大量邻域参数的积分,内层采样使这个目标可以通过迭代近似求解。具体更新式和推导见原论文 Chaudhari et al., 2017。
Entropy-SGD 与 sharpness-aware minimization (SAM) 都试图利用参数邻域的信息改善泛化,但它们的目标不同:Entropy-SGD 汇总邻域内损失的指数加权贡献,SAM 则寻找局部最坏扰动并最小化该扰动下的损失 Foret et al., 2021。两者可以放在研究平坦极小值与泛化的相关工作中比较。
参考文献
- Pratik Chaudhari, Anna Choromanska, Stefano Soatto, Yann LeCun, Carlo Baldassi, Christian Borgs, Jennifer Chayes, Sagun Levent, and Riccardo Zecchina. “Entropy-SGD: Biasing Gradient Descent into Wide Valleys.” International Conference on Learning Representations, 2017. OpenReview.
- Carlo Baldassi, Alessandro Ingrosso, Carlo Lucibello, Luca Saglietti, and Riccardo Zecchina. “Local Entropy as a Measure for Sampling Solutions in Constraint Satisfaction Problems.” Journal of Statistical Mechanics: Theory and Experiment, 2016(2):023301, 2016.
- Yiding Jiang, Behnam Neyshabur, Hossein Mobahi, Dilip Krishnan, and Samy Bengio. “Fantastic Generalization Measures and Where to Find Them.” International Conference on Learning Representations, 2020. arXiv:1912.02178.
- Pierre Foret, Ariel Kleiner, Hossein Mobahi, and Behnam Neyshabur. “Sharpness-Aware Minimization for Efficiently Improving Generalization.” International Conference on Learning Representations, 2021. OpenReview · arXiv:2010.01412.