Sharpness-Aware Minimization (SAM):同时优化损失与尖锐度
Introduction
给定训练集 $\mathcal{S}=\lbrace(x_i,y_i)\rbrace_{i=1}^n$、参数 $\theta$ 和单样本损失 $\ell(x,y;\theta)$,训练损失通常定义为
\[L_{\mathcal{S}}(\theta) =\frac{1}{n}\sum_{i=1}^{n}\ell(x_i,y_i;\theta).\]假设训练集由数据分布 $\mathcal{D}$ 独立同分布采样得到,模型在该分布上的总体损失(population loss)为
\[L_{\mathcal{D}}(\theta) =\mathbb{E}_{(x,y)\sim\mathcal{D}}[\ell(x,y;\theta)].\]实际的数据分布往往无法直接获得,因此我们用训练损失估计总体损失。这里将 $L_{\mathcal{D}}$ 称为总体损失或泛化损失;泛化间隙(generalization gap)则是 $L_{\mathcal{D}}-L_{\mathcal{S}}$。
常规梯度方法直接利用当前点的梯度减小训练损失。例如,学习率为 $\eta$ 的梯度下降更新为
\[\theta\leftarrow\theta-\eta\nabla_{\theta}L_{\mathcal{S}}(\theta).\]我们常把优化比作在山谷中寻找最低点,但最低点周围的地形也值得关注。图 1 的 (a)、(c) 是较平坦的低损失区域,(b)、(d) 则较尖锐。局部地形会影响优化与参数扰动下的损失变化;不过,能否逃离局部极小值还与势垒高度、学习率和噪声等因素有关,不能只由尖锐程度判断。
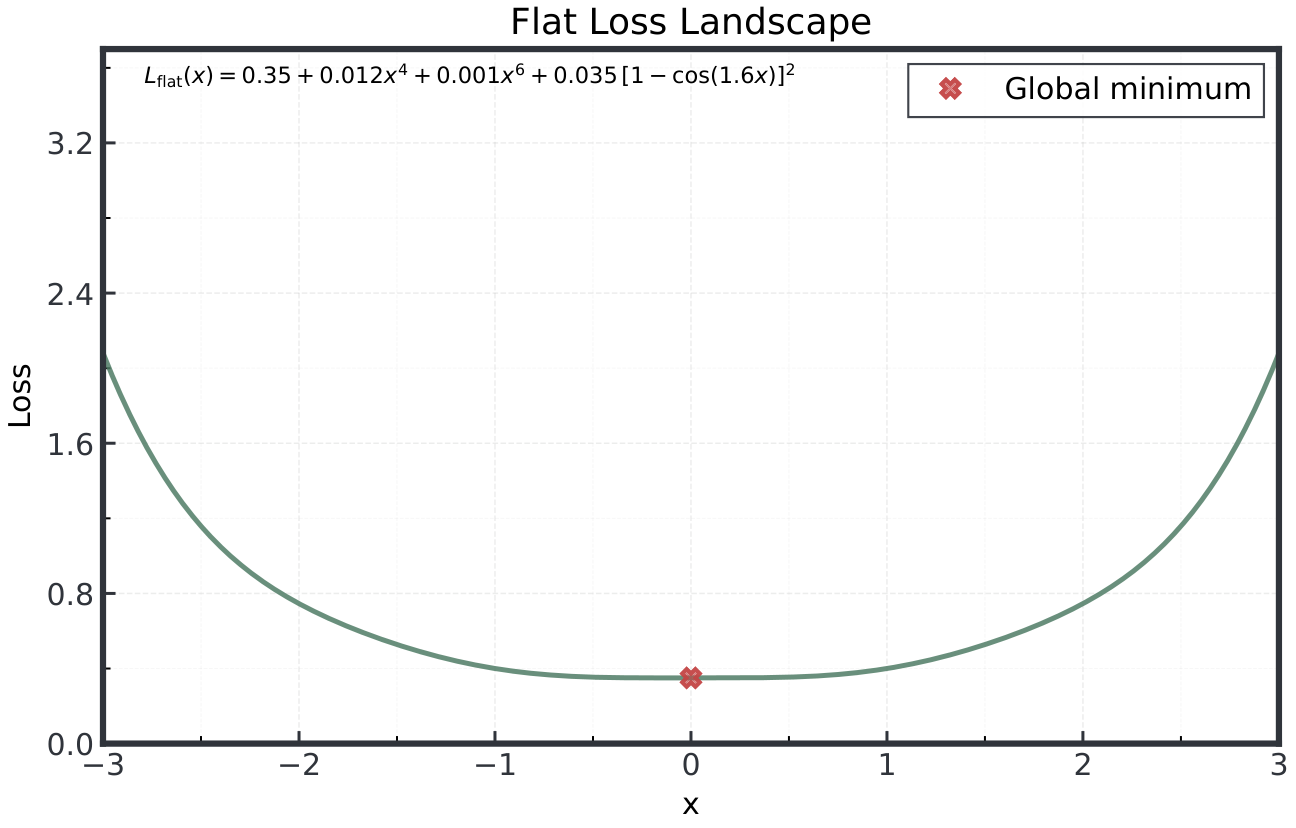
(a) Flat loss landscape (1d)
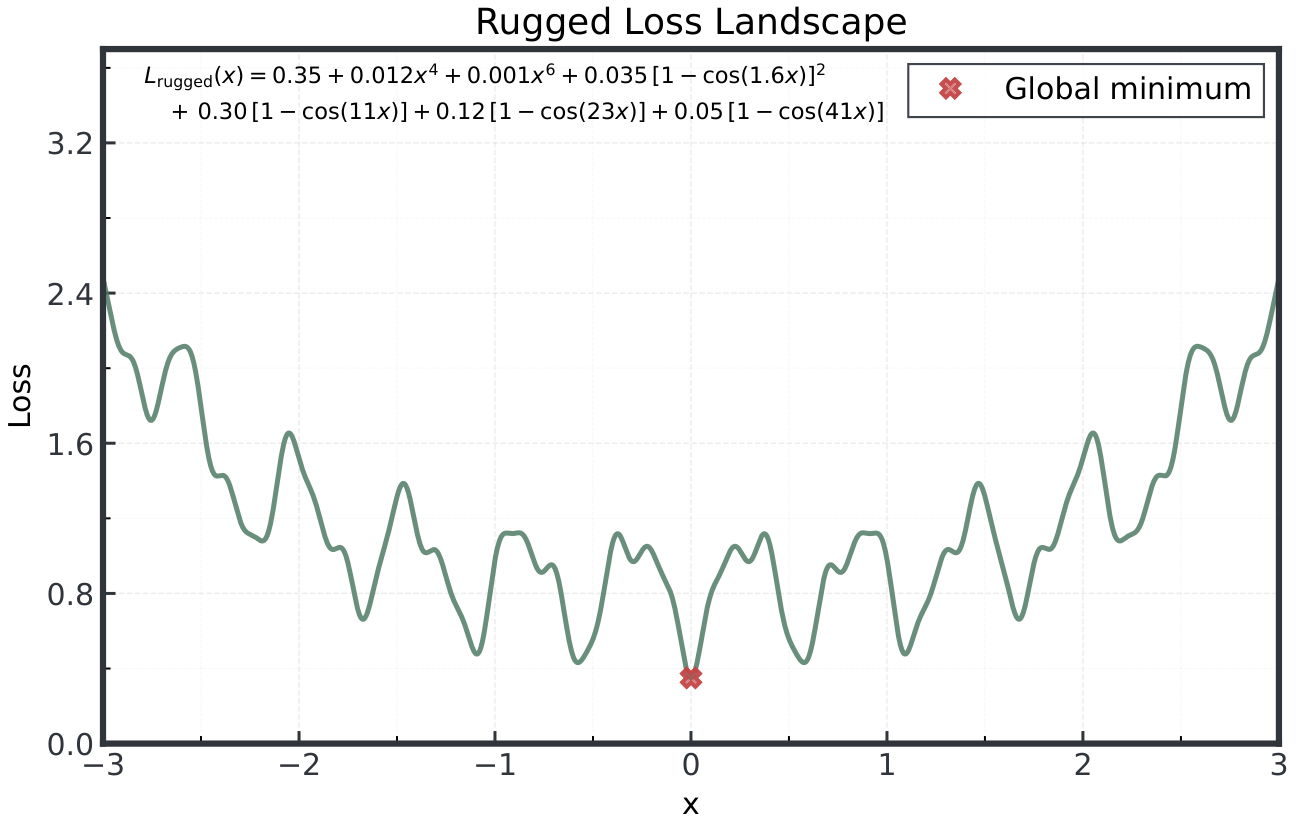
(b) Rugged landscape (1d)
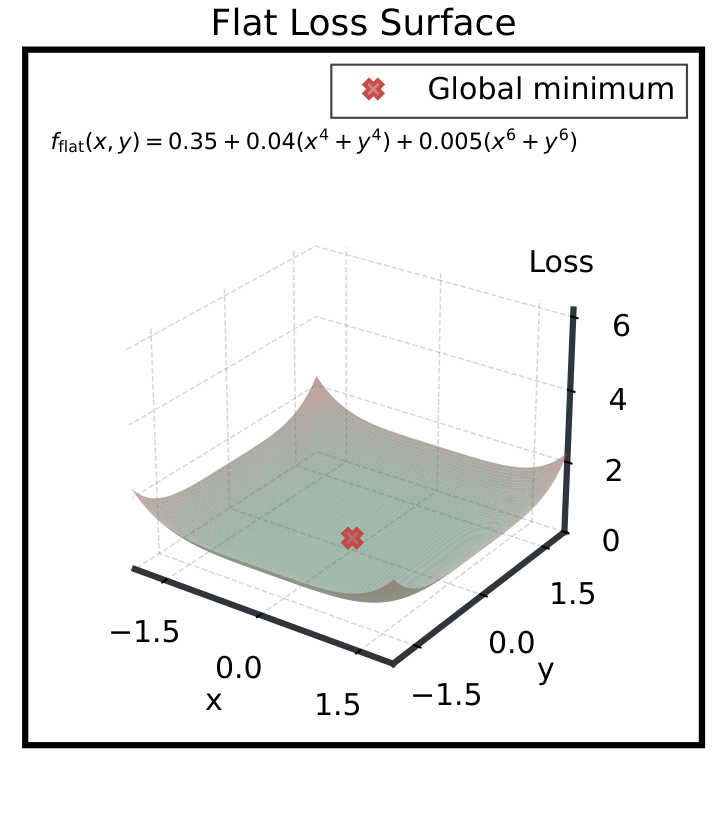
(c) Flat loss landscape (2d)
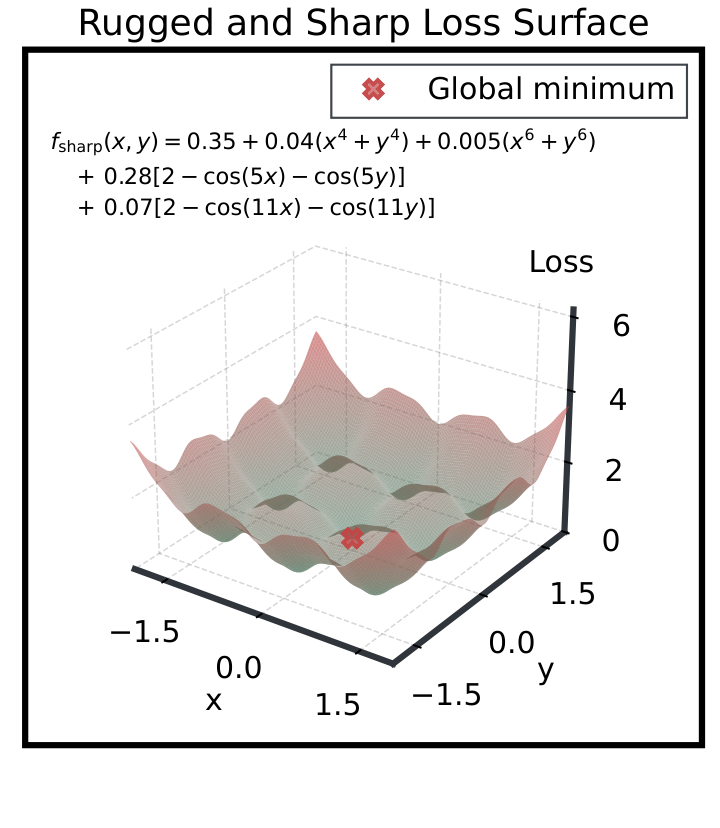
(d) Rugged landscape (2d)
基础梯度下降没有显式地约束最终解周围的地形。Sharpness-Aware Minimization(SAM)Foret et al., 2021 将参数邻域内的损失变化纳入优化目标,试图寻找训练损失低、同时周围损失也较低的解。
Sharpness-Aware Minimization
SAM 之前已有不少理论和实验工作探究损失地形的平坦性与泛化的联系。SAM 的目标是同时减小训练损失与局部尖锐度。
直觉。 如果参数受到小扰动后损失仍然很低,模型就对这类参数扰动较稳健。这为平坦区域可能有利于泛化提供了动机,但参数扰动稳健性并不直接保证模型对任意数据分布变化都稳健。
SAM 的动机之一来自 PAC-Bayes 泛化分析。在原文的假设和概率保证下,其上界可概括为
\[L_{\mathcal{D}}(\theta) \leqslant \max_{\lVert\epsilon\rVert_2\leqslant\rho} L_{\mathcal{S}}(\theta+\epsilon) +h\!\left(\frac{\lVert\theta\rVert_2^2}{\rho^2}\right).\]其中 $\rho>0$ 为邻域半径,$h$ 表示随参数范数项增大的复杂度代价;样本量、参数维度和置信度等量在这里被省略。我们无法直接优化总体损失,但可以通过优化上界中的量来构造训练目标。完整形式见文末。
邻域内的最大训练损失可以拆成当前损失与尖锐度:
\[\max_{\lVert\epsilon\rVert_2\leqslant\rho}L_{\mathcal{S}}(\theta+\epsilon) =L_{\mathcal{S}}(\theta) +\underbrace{\max_{\lVert\epsilon\rVert_2\leqslant\rho} \left[L_{\mathcal{S}}(\theta+\epsilon)-L_{\mathcal{S}}(\theta)\right]}_{\text{sharpness}}.\]因此,SAM 在这里将 sharpness 定义为半径 $\rho$ 邻域内损失相对当前点的最大增量。上界同时涉及当前训练损失、邻域尖锐度,以及与参数范数相关的复杂度代价。
SAM Algorithm
优化目标
实际训练中,SAM 用常见的 $L_2$ 正则项来代替复杂的范数代价,得到
\[\min_{\theta}\;L_{\mathcal{S}}^{\mathrm{SAM}}(\theta)+\lambda\lVert\theta\rVert_2^2, \qquad L_{\mathcal{S}}^{\mathrm{SAM}}(\theta) =\max_{\lVert\epsilon\rVert_p\leqslant\rho}L_{\mathcal{S}}(\theta+\epsilon).\]这是受到上界启发的目标选择,并不意味着正则项与原上界中的 $h$ 完全相等。算法形式可以使用一般的 $p$ 范数;前面的理论上界及下面的尖锐度分解使用 $p=2$。
\[\min_{\theta}\left[ L_{\mathcal{S}}(\theta)+\lambda\lVert\theta\rVert_2^2 +\max_{\lVert\epsilon\rVert_2\leqslant\rho} \left[L_{\mathcal{S}}(\theta+\epsilon)-L_{\mathcal{S}}(\theta)\right] \right].\]这个目标要求带正则项的训练损失和邻域尖锐度同时较小,即寻找邻域内损失也较低的参数。
与曲率的关系。 在梯度接近零、损失足够光滑且半径较小时,二阶近似将尖锐度与 Hessian 最大特征值联系起来。有限半径下的邻域最坏损失还受高阶项影响,因此低尖锐度与低曲率并非无条件等价。
近似求解内层最大化
SAM 是一个外层最小化、内层最大化的问题。精确求解每一步的内层问题通常成本较高,因此论文使用局部一阶近似构造扰动,再近似计算外层梯度。
当 $\rho$ 足够小、局部一阶近似合理时,
\[L_{\mathcal{S}}(\theta+\epsilon) \approx L_{\mathcal{S}}(\theta)+\epsilon^T\nabla_{\theta}L_{\mathcal{S}}(\theta).\]记当前梯度为 $g=\nabla_{\theta}L_{\mathcal{S}}(\theta)$,近似扰动满足
\[\begin{aligned} \epsilon^*(\theta) &\in\operatorname*{arg\,max}_{\lVert\epsilon\rVert_p\leqslant\rho} L_{\mathcal{S}}(\theta+\epsilon),\\ \hat\epsilon(\theta) &\in\operatorname*{arg\,max}_{\lVert\epsilon\rVert_p\leqslant\rho}g^T\epsilon. \end{aligned}\]这里 $\epsilon^*$ 是原内层问题的最优扰动,$\hat\epsilon$ 则是线性化问题的最优扰动。对偶范数指数满足 $1/p+1/q=1$。根据 Hölder 不等式,
\[g^T\epsilon \leqslant\sum_i|g_i\epsilon_i| \leqslant\lVert g\rVert_q\lVert\epsilon\rVert_p \leqslant\rho\lVert g\rVert_q.\]当扰动与梯度按对偶范数的方式对齐,且使用完整半径时,可以达到上述上界。对于 $1<p<\infty$ 且 $g\neq0$,一个最优解为
\[\hat\epsilon_i =\rho\frac{\operatorname{sign}(g_i)|g_i|^{q-1}} {\left(\sum_j|g_j|^q\right)^{1/p}} =\rho\frac{\operatorname{sign}(g_i)|g_i|^{q-1}} {\lVert g\rVert_q^{q-1}}.\]两个常见情形是:
- $p=2$、$q=2$:$\hat\epsilon=\rho g/\lVert g\rVert_2$,沿梯度方向移动固定的 $L_2$ 距离 $\rho$。
- $p=\infty$、$q=1$:可取 $\hat\epsilon_i=\rho\operatorname{sign}(g_i)$,每个非零梯度坐标都走到对应边界。
当 $g=0$ 时,线性化问题不能提供优先方向,可以取 $\hat\epsilon=0$;实现中也通常给归一化分母加上很小的数以避免除零。
近似计算外层梯度
得到扰动后,邻域最坏损失近似为
\[L_{\mathcal{S}}^{\mathrm{SAM}}(\theta) \approx L_{\mathcal{S}}(\theta+\hat\epsilon(\theta)).\]对于列向量梯度,令 $J_{\hat\epsilon}(\theta)$ 为扰动映射的雅可比矩阵,链式法则给出
\[\nabla_{\theta}L_{\mathcal{S}}(\theta+\hat\epsilon(\theta)) =\left(I+J_{\hat\epsilon}(\theta)\right)^T \left.\nabla_u L_{\mathcal{S}}(u)\right|_{u=\theta+\hat\epsilon(\theta)} =\tilde g+J_{\hat\epsilon}(\theta)^T\tilde g.\]其中 $\tilde g$ 是在扰动点计算的损失梯度。由于 $\hat\epsilon$ 本身包含当前梯度,对其求导会涉及 Hessian,增加计算开销。SAM 忽略这一二阶部分,将扰动视为常量,使用
\[\nabla_{\theta}L_{\mathcal{S}}^{\mathrm{SAM}}(\theta) \approx \left.\nabla_u L_{\mathcal{S}}(u)\right|_{u=\theta+\hat\epsilon(\theta)}.\]因此,一个最基本的 SAM 步骤需要两次梯度计算:先在当前参数计算梯度以构造扰动,再在扰动参数计算用于更新的梯度。若目标中的正则项写作 $\lambda\lVert\theta\rVert_2^2$,则普通梯度下降形式的更新为
\[\theta_{t+1}=\theta_t-\eta\left(\tilde g_t+2\lambda\theta_t\right).\]实践中也可以把 SAM 与 SGD、动量等基础优化器组合;相应的权重衰减约定需与具体实现保持一致。
Additional Notes
GD 与 SAM 的更新比较
以 $p=2$ 为例,忽略正则项时,普通 GD 和 SAM 的区别在于提取更新方向的位置:
- GD:在当前点 $\theta_t$ 计算 $g_t$,直接更新为 $\theta_{t+1}=\theta_t-\eta g_t$。
- SAM:先计算 $g_t$,再构造 $\tilde\theta_t=\theta_t+\rho g_t/\lVert g_t\rVert_2$;随后在 $\tilde\theta_t$ 计算 $\tilde g_t$,最后从原始点 $\theta_t$ 出发,更新为 $\theta_{t+1}^{\mathrm{SAM}}=\theta_t-\eta\tilde g_t$。
第二步中的探测距离为 $\rho$,需要对梯度归一化。图 2 展示了相应的更新示意图。
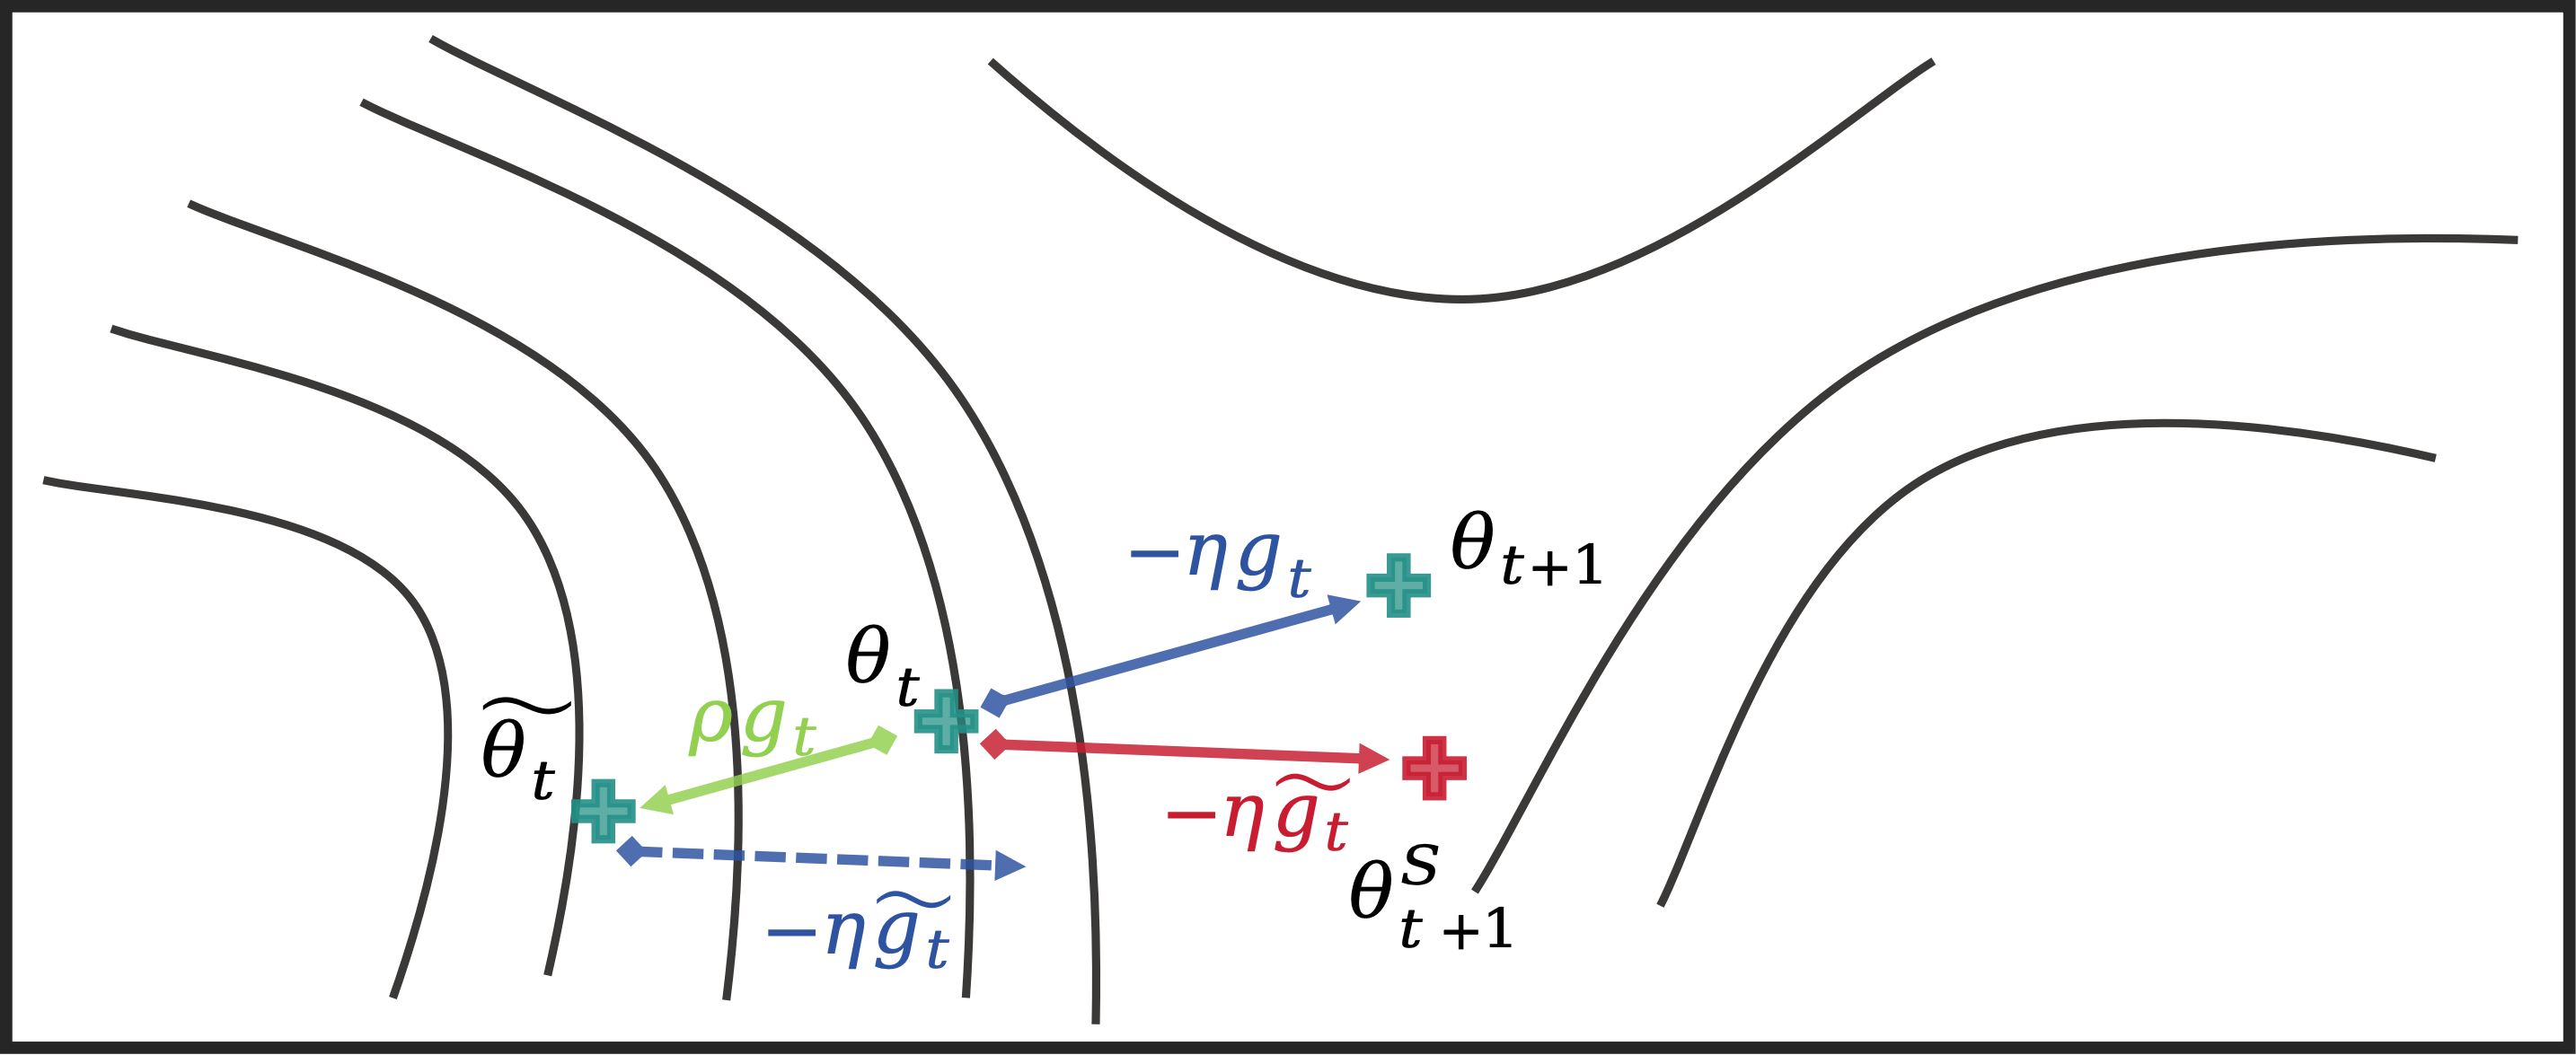
泛化上界的完整形式
原文给出的上界形式为
\[L_{\mathcal{D}}(\theta) \leqslant\max_{\lVert\epsilon\rVert_2\leqslant\rho}L_{\mathcal{S}}(\theta+\epsilon) +\sqrt{\frac{ k\log\left(1+\frac{\lVert\theta\rVert_2^2}{\rho^2} \left(1+\sqrt{\frac{\log n}{k}}\right)^2\right) +4\log\frac{n}{\delta}+\widetilde O(1) }{n-1}}.\]其中 $n=\lvert\mathcal{S}\rvert>1$,$k$ 是参数维度,$\delta$ 是置信度参数。这个结论带有训练集采样的概率保证,并依赖原文中的条件,包括总体损失在相应高斯扰动下平均不下降的假设:
\[L_{\mathcal{D}}(\theta) \leqslant\mathbb{E}_{\epsilon\sim\mathcal{N}(0,\sigma^2I)} \left[L_{\mathcal{D}}(\theta+\epsilon)\right].\]高斯噪声的尺度 $\sigma$ 与邻域半径 $\rho$ 的对应关系应按原文证明选择,不能把高斯方差和确定性邻域半径直接视为同一个量。上界的准确条件及省略项见论文附录 A。
参考文献
- Pierre Foret, Ariel Kleiner, Hossein Mobahi, and Behnam Neyshabur. “Sharpness-Aware Minimization for Efficiently Improving Generalization.” International Conference on Learning Representations, 2021. OpenReview · arXiv:2010.01412.